DevOps und CI/CD: Skalierbare IT-Lösungen zuverlässig entwickeln und betreiben
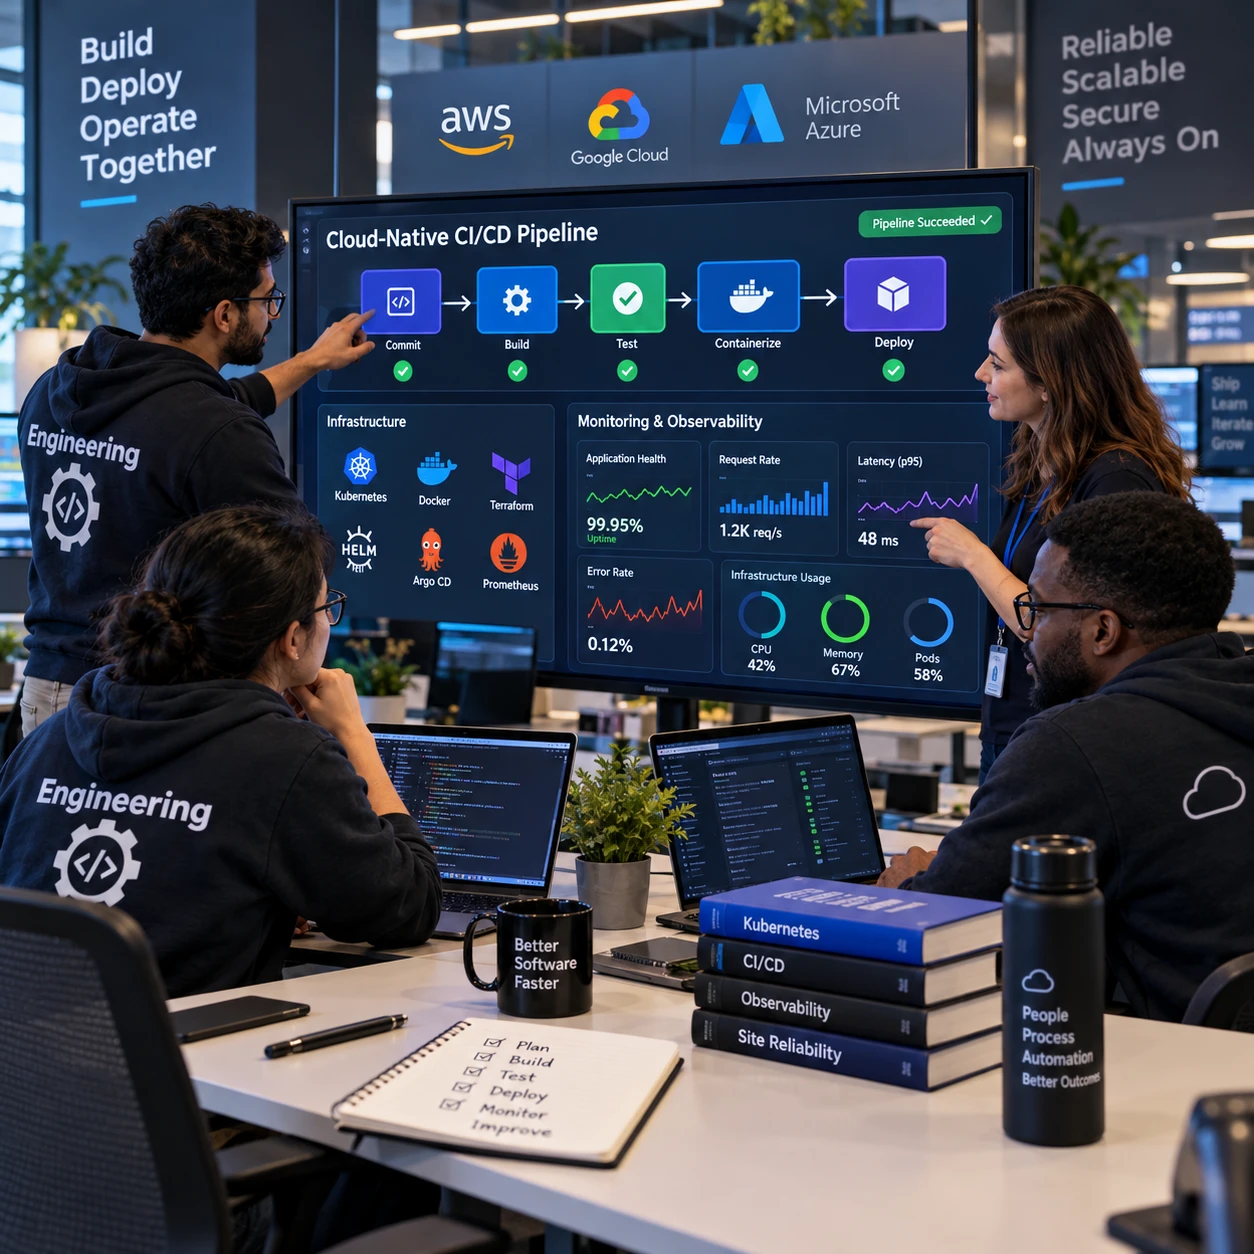
Wenn Anwendungen wachsen, steigen nicht nur Nutzerzahlen und Datenmengen. Auch Änderungen müssen häufiger, sicherer und über komplexere Systeme hinweg ausgeliefert werden. DevOps und Continuous Integration/Deployment (CI/CD) verbinden dafür Zusammenarbeit, Automatisierung und Betriebsfeedback. Sie schaffen verlässliche Abläufe für skalierbare IT-Lösungen, ohne allein durch den Einsatz bestimmter Tools Skalierung zu garantieren.
DevOps und CI/CD im Überblick
DevOps ist ein Arbeits- und Organisationsansatz, der Entwicklung und Betrieb enger zusammenbringt; CI/CD automatisiert wesentliche Schritte vom Code bis zur Bereitstellung. Zusammengenommen helfen sie Teams, Änderungen nachvollziehbar und kontrolliert auszuliefern.
Continuous Integration (CI) bedeutet, dass Entwicklerinnen und Entwickler Code regelmäßig in eine gemeinsame Versionsverwaltung integrieren. Automatisierte Builds und Tests prüfen jede Änderung früh. Fehler lassen sich dadurch häufig näher an ihrer Ursache finden, statt erst kurz vor einem Release.
Continuous Delivery hält getestete Änderungen so bereit, dass sie grundsätzlich veröffentlicht werden können. Der Produktionsstart wird dabei meist bewusst durch eine Freigabe ausgelöst. Beim Continuous Deployment gelangen alle Änderungen, die die definierten Prüfungen bestehen, automatisch in die Produktion. Diese Variante verlangt besonders belastbare Tests, Überwachung und Rückfallmechanismen.
DevOps geht über die Pipeline hinaus: Teams teilen Verantwortung für Bereitstellung, Zuverlässigkeit und Betriebsergebnisse. Automatisierung reduziert wiederkehrende Handarbeit, ersetzt aber weder klare Zuständigkeiten noch eine sinnvolle Release-Strategie. Der Erfolg hängt davon ab, ob Kultur, Prozesse und Technik zusammenpassen.
Warum skalierbare IT-Lösungen andere Abläufe brauchen
Skalierbare IT-Lösungen brauchen Abläufe, die mit wachsender Nutzung, häufigen Änderungen und zunehmender Systemkomplexität mithalten. Ohne standardisierte Prozesse wird jede zusätzliche Anwendung oder Umgebung zu einer weiteren Fehlerquelle.
Bei einem kleinen System kann ein Team Änderungen noch manuell koordinieren. In einer größeren Landschaft mit mehreren Services, Cloud-Ressourcen und Entwicklungsteams werden solche Übergaben schnell zum Engpass. Ein Release, das von einzelnen Personen oder detaillierten Handbüchern abhängt, ist schwer zu wiederholen und anfällig für Wissensverlust.
CI/CD schafft einen überprüfbaren Weg für Änderungen. Teams können Funktionen in kleineren Schritten veröffentlichen und Probleme gezielter eingrenzen. Das ist besonders relevant für cloud-native Architekturen, in denen Anwendungen aus mehreren unabhängig deploybaren Komponenten bestehen können. Allerdings steigt mit verteilten Systemen auch der Aufwand für Abhängigkeiten, Netzwerke und Fehleranalyse.
Skalierbarkeit ist daher mehr als technische Kapazität. Dazu gehören belastbare Deployments, klare Verantwortlichkeiten und Monitoring, das zeigt, wie sich eine Änderung auf den laufenden Betrieb auswirkt. Eine Pipeline kann Releases beschleunigen; sie kann aber keine unklare Architektur oder fehlende Betriebsstandards ausgleichen.
So funktioniert eine CI/CD-Pipeline
Eine CI/CD-Pipeline führt eine Codeänderung durch festgelegte Schritte: Sie wird versioniert, gebaut, geprüft und für eine kontrollierte Bereitstellung vorbereitet. Jeder Schritt liefert ein nachvollziehbares Ergebnis und kann bei Fehlern den weiteren Ablauf stoppen.
Ein typischer Ablauf sieht so aus:
- Änderung und Versionskontrolle: Eine Entwicklerin oder ein Entwickler legt Code in einem Branch ab und stellt ihn zur Überprüfung bereit. Die Versionsverwaltung dokumentiert, was geändert wurde und von wem.
- Build: Die Pipeline erstellt ein ausführbares Artefakt oder ein Container-Image. Wiederholbare Build-Schritte verringern Unterschiede zwischen Entwicklungs-, Test- und Produktionsumgebung.
- Automatisierte Tests: Je nach Projekt prüfen Unit-, Integrations- und Ende-zu-Ende-Tests die Änderung. Sicherheits- und Qualitätsprüfungen können ebenfalls Teil der Pipeline sein.
- Bereitstellung in einer Testumgebung: Teams prüfen das Artefakt unter realitätsnahen Bedingungen, bevor es in die Produktion gelangt.
- Freigabe und Release: Continuous Delivery wartet auf eine manuelle Freigabe; Continuous Deployment veröffentlicht nach bestandenen Prüfungen automatisch.
- Beobachtung und Rückmeldung: Monitoring und Observability helfen, Fehler, Leistungseinbußen oder ungewöhnliches Verhalten nach dem Release zu erkennen.
Die Pipeline sollte möglichst dasselbe Artefakt durch die Umgebungen transportieren. So wird vermieden, dass für die Produktion ein abweichendes Paket gebaut wird. Für sensible Systeme können zusätzliche Freigaben sinnvoll sein; sie erhöhen die Kontrolle, verlängern aber den Weg bis zum Release.
Praktiken für sichere und wiederholbare Releases
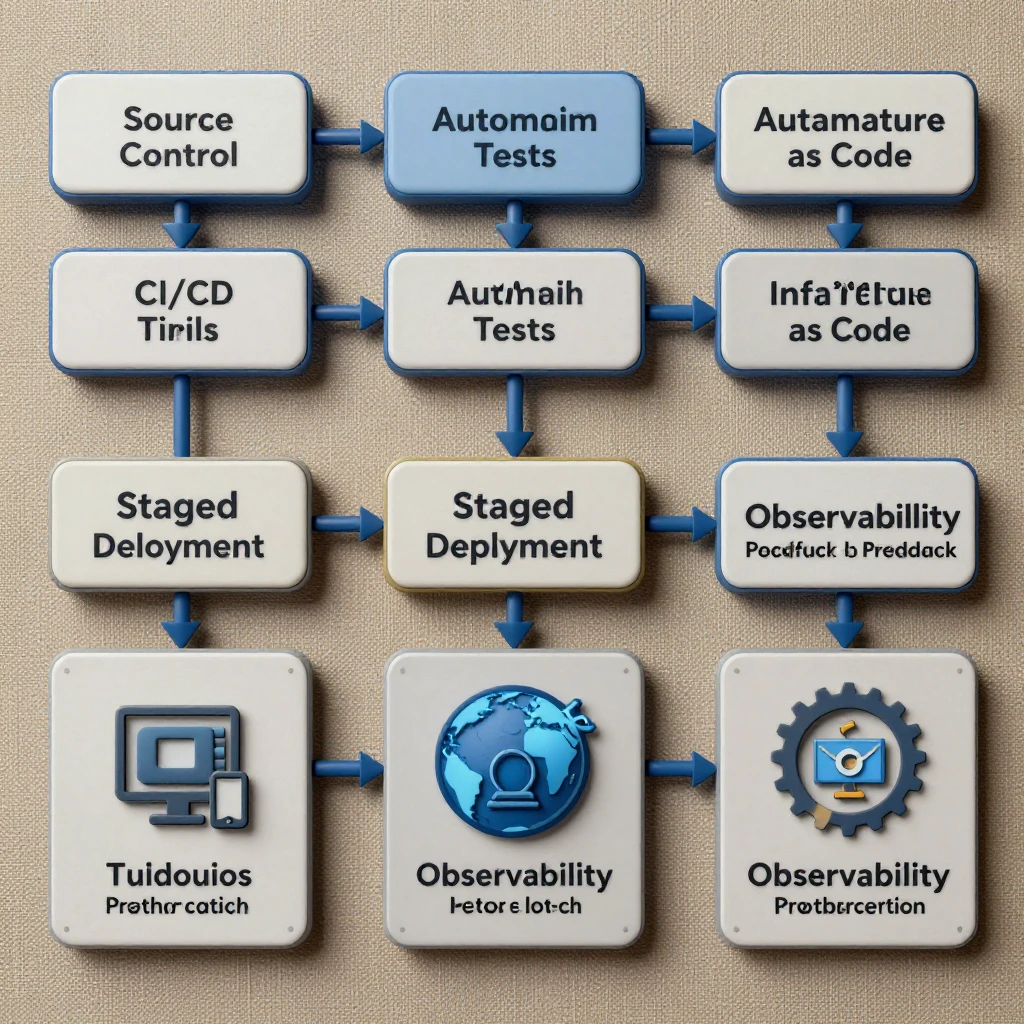
Sichere und wiederholbare Releases entstehen, wenn Tests, Infrastruktur als Code, Versionskontrolle und Monitoring gemeinsam eingesetzt werden. Jeder Baustein deckt eine andere Fehlerklasse ab; keiner davon bietet allein vollständige Sicherheit.
Automatisierte Tests nach Risiko staffeln
Automatisierte Tests sollten schnell auf häufige Fehler reagieren und zugleich kritische Abläufe abdecken. Unit-Tests prüfen einzelne Funktionen, Integrationstests das Zusammenspiel von Komponenten und Ende-zu-Ende-Tests ausgewählte Nutzerprozesse. Zu viele langsame, fragile Tests können die Pipeline selbst zum Hindernis machen. Beginnen Sie deshalb mit den wichtigsten Geschäftsabläufen und erweitern Sie die Testabdeckung gezielt.
Infrastruktur als Code und Versionskontrolle nutzen
Infrastruktur als Code (IaC) beschreibt Umgebungen in versionierten, überprüfbaren Dateien. Änderungen an Netzwerk, Rechenleistung oder Cloud-Ressourcen lassen sich so kontrolliert prüfen und reproduzieren. Das senkt manuelle Abweichungen, erfordert aber Schutz sensibler Zugangsdaten und einen Plan für Änderungen an bestehenden Ressourcen.
Auch Pipeline-Konfigurationen und Deployment-Regeln gehören in die Versionskontrolle. Code-Reviews schaffen eine zweite Prüfung, bevor Änderungen wirksam werden. Für verschiedene Umgebungen sollten Zugangsdaten und Berechtigungen getrennt verwaltet werden, statt Geheimnisse in Skripten oder Repositories abzulegen.
Monitoring und Observability einplanen
Monitoring verfolgt definierte Kennzahlen und Alarme; Observability nutzt Metriken, Logs und Traces, um Ursachen in komplexen Systemen besser zu untersuchen. Teams sollten vor einem Release festlegen, welche Signale auf einen Fehler hindeuten und wer darauf reagiert. Ein automatischer Rollback kann helfen, wenn klare Auslöser definiert sind. Er ist jedoch kein Ersatz für Ursachenanalyse und Wiederherstellungstests.
Einführung im Unternehmen: Voraussetzungen und Stolpersteine
Eine erfolgreiche Einführung beginnt mit einem klar abgegrenzten Prozess, einem verantwortlichen Team und realistischen Sicherheitsanforderungen. Unternehmen sollten ihre vorhandenen Systeme berücksichtigen und die CI/CD-Pipeline schrittweise aufbauen, statt alle Anwendungen gleichzeitig umzustellen.
Ein guter Startpunkt ist ein überschaubarer Service mit häufigen Änderungen und einem Team, das Entwicklung und Betrieb gemeinsam betrachtet. Dokumentieren Sie zunächst den heutigen Weg von einer Codeänderung bis zur Produktion: Welche manuellen Übergaben gibt es? Wo entstehen Wartezeiten? Welche Prüfungen sind bereits vorhanden? Daraus lässt sich ein konkreter erster Automatisierungsschritt ableiten, etwa ein reproduzierbarer Build oder ein Testlauf bei jeder Änderung.
- Fehler: Tools statt Arbeitsabläufe auswählen. Ein neues CI-System löst keine unklaren Zuständigkeiten. Legen Sie zuerst fest, wer Pipeline, Freigaben und Störungen verantwortet; wählen Sie Werkzeuge danach passend zur bestehenden IT-Landschaft.
- Fehler: Tests vollständig automatisieren wollen, bevor ein Release möglich ist. Das verzögert den Einstieg. Automatisieren Sie zuerst wiederkehrende, risikoreiche Prüfungen und verbessern Sie die Abdeckung schrittweise.
- Fehler: Sicherheit ans Ende der Pipeline verschieben. Späte Prüfungen können Releases blockieren und kritische Lücken sichtbar machen, wenn Änderungen bereits integriert sind. Berücksichtigen Sie Berechtigungen, Abhängigkeiten und Geheimnisverwaltung früh.
- Fehler: Automatisierung ohne Betriebsfeedback einführen. Schnellere Deployments helfen wenig, wenn niemand Auswirkungen erkennt oder auf Alarme reagiert. Vereinbaren Sie Monitoring, Bereitschaft und einen getesteten Rückfallweg.
Bei gewachsenen Systemen ist eine schrittweise Integration oft realistischer als ein kompletter Umbau. Legacy-Anwendungen können zunächst über Schnittstellen, Artefakt-Repositories oder standardisierte Deployment-Schritte eingebunden werden. Externe Engineering- oder IT-Beratung kann nützlich sein, wenn intern Pipeline-Kompetenz fehlt, Sicherheitsanforderungen unklar sind oder viele Teams gemeinsame Standards benötigen. Die Verantwortung für Architektur und Betriebsmodell sollte dennoch im Unternehmen verankert bleiben.
DevOps und CI/CD passend zur eigenen IT-Landschaft einsetzen
DevOps und CI/CD passen zur eigenen IT-Landschaft, wenn Einführung und Automatisierung an Änderungsfrequenz, Risiken, Teamstruktur und bestehende Systeme angepasst werden. Der sinnvollste nächste Schritt ist meist der, der einen konkreten Engpass messbar reduziert.
Prüfen Sie Ihre Ausgangslage anhand von vier Fragen: Wie oft werden Anwendungen geändert? Welche manuellen Schritte verursachen die meisten Verzögerungen oder Fehler? Welche Anforderungen gelten für Sicherheit und Freigabe? Und können Teams nach einem Release erkennen, ob der Dienst stabil läuft? Die Antworten helfen dabei, zwischen Continuous Delivery mit Freigabeschritt und Continuous Deployment zu wählen und passende Prüfungen festzulegen.
Definieren Sie für einen Pilotprozess einfache Kennzahlen, zum Beispiel die Zeit von der Codeänderung bis zur Bereitstellung, die Häufigkeit fehlgeschlagener Releases und die Zeit bis zur Wiederherstellung. Diese Werte zeigen, ob die neue Arbeitsweise tatsächlich hilft. Vergleichen Sie sie über einen sinnvollen Zeitraum und im Kontext des jeweiligen Services, nicht als pauschalen Wettbewerb zwischen Teams.
Eine tragfähige Einführung verbindet technische Standards mit gemeinsamer Verantwortung. Starten Sie klein, sichern Sie den Betrieb ab und übertragen Sie bewährte Abläufe erst dann auf weitere Services. So entsteht eine CI/CD-Pipeline, die zur Organisation passt und mit den Anforderungen an skalierbare IT-Lösungen mitwachsen kann.
Häufige Fragen zu DevOps und CI/CD
Was ist der Unterschied zwischen Continuous Delivery und Continuous Deployment?
Bei Continuous Delivery ist eine getestete Änderung jederzeit veröffentlichungsbereit, wird aber meist manuell freigegeben. Continuous Deployment veröffentlicht Änderungen nach bestandenen automatisierten Prüfungen automatisch in der Produktion.
Welche Voraussetzungen braucht eine CI/CD-Pipeline?
Grundlegend sind Versionskontrolle, definierte Build- und Testschritte, eine geeignete Ausführungsumgebung sowie klare Zuständigkeiten. Für Produktionsdeployments kommen je nach Risiko Sicherheitsprüfungen, Berechtigungsregeln, Monitoring und Rückfallmöglichkeiten hinzu.
Wie unterstützen DevOps und CI/CD die Skalierbarkeit?
Sie standardisieren wiederkehrende Abläufe und machen Änderungen überprüfbarer. Automatisierte Tests und Deployments können manuelle Engpässe reduzieren; die tatsächliche Skalierbarkeit hängt zusätzlich von Architektur, Infrastruktur und Betriebsorganisation ab.
Wie lässt sich eine bestehende IT-Landschaft schrittweise integrieren?
Beginnen Sie mit einem Service oder einem einzelnen Pipeline-Schritt, etwa einem automatisierten Build. Binden Sie bestehende Repositories, Testumgebungen und Deployments schrittweise ein und erweitern Sie den Prozess, sobald Zuständigkeiten und Rückfallwege funktionieren.